Uprość proces
Usuń zbędne kroki, decyzje i przekazania.
USPRAWNIAMY PROCESY OPERACYJNE I DECYZYJNE
Jeśli proces wymaga kopiowania danych, ręcznych kontroli, maili, arkuszy i kolejnych obejść — najpierw sprawdzamy, gdzie naprawdę znika czas i pieniądze. Dopiero potem dobieramy najprostsze rozwiązanie, które usuwa tarcie.
01 / KOSZT STATUS QUO
Problem nie musi wyglądać jak awaria. Częściej jest to godzina tu, piętnaście minut tam, kopiowanie między systemami, ręczne sprawdzanie i wiedza zamknięta w głowie jednej osoby. Przy skali te drobiazgi stają się kosztem operacyjnym.
Nie zgadujemy ROI. Wpisz własne liczby i zobacz skalę problemu przed rozmową o rozwiązaniu.
Kalkulator nie obiecuje oszczędności. Pokazuje wyłącznie koszt obecnego sposobu pracy na podstawie podanych przez Ciebie danych.
02 / KIEDY NIE WARTO BUDOWAĆ
Jeśli prostsza zmiana procesu, arkusz albo gotowa integracja rozwiązuje problem — to właśnie rekomendujemy. Własny system ma sens dopiero wtedy, gdy prostsze opcje nie dowożą celu.
Usuń zbędne kroki, decyzje i przekazania.
Jeśli już istnieje dobre rozwiązanie, nie ma sensu go odtwarzać.
API, synchronizacja i automatyczny przepływ danych często rozwiązują większość problemu.
Powtarzalne reguły i ręczne operacje przejmują workflowy, RPA lub usługi backendowe.
Dedykowana aplikacja, agent, vision lub model dopiero wtedy, gdy daje przewagę w konkretnym procesie.
03 / PRAWDZIWY CEL
Pytamy, co ma się zmienić w pracy firmy. Technologia pojawia się dopiero jako mechanizm prowadzący do tego wyniku.
Specjaliści nie powinni spędzać dnia na kopiowaniu, porządkowaniu i sprawdzaniu powtarzalnych danych.
Proces ma przechodzić od wejścia do decyzji bez czekania na ręczne przekazania między osobami i systemami.
Powtarzalne kryteria, kontrola danych i automatyczna walidacja ograniczają koszt poprawek i niezgodności.
Wynik procesu ma być widoczny, mierzalny i możliwy do prześledzenia — nie ukryty w mailach i lokalnych plikach.
04 / JAK PRACUJEMY
Każdy etap ma zmniejszać ryzyko złej inwestycji: od zrozumienia problemu, przez wybór prostszej drogi, po pomiar rezultatu.
Kto robi co, w jakim systemie, z jakimi danymi i gdzie pojawia się oczekiwanie, ręczna praca lub ryzyko.
Czas, liczba osób, błędy, opóźnienia, dodatkowe kontrole i koszt dalszego skalowania obecnego sposobu pracy.
Usuwamy kroki, które nie tworzą wartości. Nie automatyzujemy chaosu tylko dlatego, że można.
Gotowe narzędzie, integracja, automatyzacja, dedykowana aplikacja albo AI — w tej kolejności, w której ma to sens.
Najpierw sprawdzamy kluczowe założenie. Dopiero potem rozszerzamy rozwiązanie i wpinamy je w operacje.
Czy spadł czas procesu? Czy jest mniej ręcznych kroków? Czy wynik jest bardziej przewidywalny? To jest punkt odniesienia.
05 / REALIZACJE
Case study ma odpowiedzieć na pięć pytań: jak było, co bolało, co zmieniliśmy, jak wygląda nowy proces i dlaczego ma to znaczenie biznesowe.
Praca z dużą liczbą dokumentów prawnych oznaczała ręczne przygotowanie treści, pilnowanie danych wrażliwych i wielokrotne sprawdzanie materiału zanim mógł zostać wykorzystany dalej.
Dokumenty zawierają PII, ale równocześnie muszą zachować strukturę i kontekst potrzebny do dalszej pracy.
Ręczne anonimizowanie i przygotowywanie dokumentów jest wolne, podatne na pominięcia i trudne do skalowania.
Zaprojektowaliśmy pipeline, który lokalnie wykrywa i pseudonimizuje dane wrażliwe przed wysłaniem treści do LLM, a następnie weryfikuje wynik i — gdy potrzeba — lokalnie przywraca dane.
Ingest → pseudonimizacja → praca modelu → weryfikacja → human-in-the-loop dla niepewnych przypadków → wynik z pełną ścieżką audytową.
Rezultatem nie jest „chat z dokumentem”, tylko powtarzalny proces, który odzyskuje dziesiątki godzin pracy tygodniowo przy zachowaniu kontroli nad danymi.
FastAPI · PostgreSQL · token vault · Regex/NER · LLM · verifier · reidentifier · asynchronous worker · audit log · React/Vite · Docker.
Grafika jest autorską rekonstrukcją architektury. Nie pokazuje dokumentów ani danych klienta.
Przy wielu liniach produkcyjnych sama detekcja OK/NOK nie wystarcza. Wynik musi być powtarzalny, zapisany i możliwy do porównania między miejscami, zmianami i okresami.
Kontrola jakości obejmowała 17 linii produkcyjnych i wymagała spójnego sposobu rejestrowania wyniku.
Bez jednego cyfrowego standardu trudniej porównywać wyniki, śledzić odchylenia i budować dane do dalszego doskonalenia procesu.
Warstwa Computer Vision zamienia obserwację obrazu w ustandaryzowany wynik kontroli, który można zapisać i wykorzystać dalej w procesie jakościowym.
Obraz → detekcja → wynik OK/NOK → zapis → identyfikowalność → analiza zmian w czasie.
Wartość nie kończy się na automatycznej detekcji. Powstaje wspólny standard kontroli dla 17 linii oraz dane, które można analizować i rozwijać.
Ze względu na NDA nie publikujemy zdjęć stanowisk, danych produkcyjnych ani interfejsu klienta. Grafika poniżej jest abstrakcyjną wizualizacją architektury kontroli.
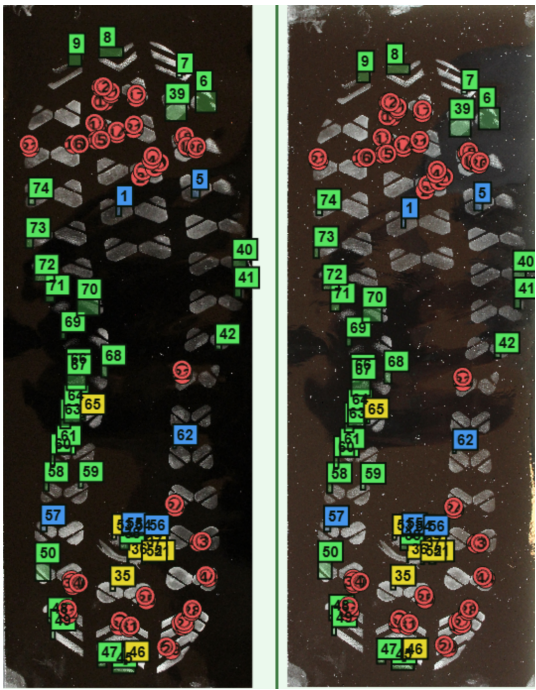
Wkład w rozwój Forensic Biometrics Studio — aplikacji desktopowej do zestawiania obrazów śladów kryminalistycznych, oznaczania odpowiadających cech i przygotowania uporządkowanego materiału porównawczego.
Ekspert pracuje na dwóch obrazach jednocześnie i musi zachować precyzję oznaczeń również podczas przesuwania i powiększania obrazu.
Nowe typy oznaczeń wymagają spójnej obsługi rysowania, zdarzeń myszy, widoczności, tłumaczeń, skrótów oraz zapisu i odczytu danych.
Rozszerzanie klas anotacji i handlerów, logika rysowania uwzględniająca viewport przy zoomie, integracja z toolbar, skrótami i mechanizmem serializacji oznaczeń.
Załaduj obrazy → oznacz odpowiadające cechy → porównaj → zapisz dane → wygeneruj uporządkowany materiał do dalszej pracy.
Software ma wspierać sposób pracy eksperta, nie wymuszać na nim pracy wokół ograniczeń interfejsu. Tu wartością jest precyzyjne narzędzie i powtarzalny workflow analizy.
R&D / ENGINEERING
R&D oddzielamy od case studies klientowskich. Tu pokazujemy zdolność do budowania i testowania rozwiązań tam, gdzie problem nie ma gotowej odpowiedzi.
Pipeline do wirtualnego przymierzania zaprojektowany wokół zachowania tożsamości osoby i obrazu wejściowego: klasyfikacja garmentu, parsing ubrań, generacja tylko w masce i twardy freeze poza nią.
Prototyp łączy sensory temperatury, wilgotności, światła i wilgotności gleby z lokalną logiką sterującą drzwiami, zaworem nawadniania i dozowaniem paszy. Dane są wysyłane do InfluxDB, a decyzje mogą być wykonywane lokalnie.
06 / GDZIE SZUKAĆ DŹWIGNI
Nie musisz wiedzieć, jakiego rozwiązania potrzebujesz. Wystarczy, że rozpoznajesz jeden z tych typów tarcia.
Ekstrakcja, klasyfikacja, walidacja, generowanie materiałów, obieg i dane wrażliwe.
Raportowanie, controlling, dopasowanie dokumentów, statusy, reguły i kontrole.
Workflowy, integracje, powtarzalne decyzje, zadania cykliczne i przekazywanie danych.
Computer Vision, sensory, automatyka, traceability i narzędzia dla inżynierów.
Synchronizacja danych, API, ERP/CRM, automatyczny import/eksport i eliminacja kopiuj-wklej.
Wyszukiwanie, RAG, klasyfikacja, uporządkowane repozytoria wiedzy i narzędzia wspierające decyzję.
Dedykowane narzędzia, formularze, dashboardy, role, audit trail i integracje z istniejącym środowiskiem.
Narzędzia CAD/Python, automatyzacja obliczeń i logika osadzona dokładnie tam, gdzie pracuje inżynier.
07 / ZMNIEJSZENIE RYZYKA
Nie zaczynamy od wyceny „wdrożenia AI”. Najpierw sprawdzamy, czy problem w ogóle jest wart budowania rozwiązania.
PROCESS DISCOVERY
Analiza procesu i wąskich gardeł, 2–3 kierunki poprawy, ocena gdzie automatyzacja ma sens i rekomendacja następnego kroku. Jeśli przechodzimy do realizacji projektu, 150 PLN odliczamy od pierwszej faktury.
Płatność przez Stripe. Termin wybierasz po płatności.START WITH THE PROCESS
Nie musisz wiedzieć, czy potrzebujesz AI, integracji czy aplikacji. Opisz obecny sposób pracy i efekt, który miałby znaczenie.